

数据加载器
了解如何创建数据加载器管道,为你的 RAG 应用提供数据。
要构建一个结构化的 AI 应用,你需要能够将你拥有的所有信息转换为文本,这样你才能生成嵌入、将它们保存到向量存储中,然后把你的 Agent 输入进去以回答用户的问题。
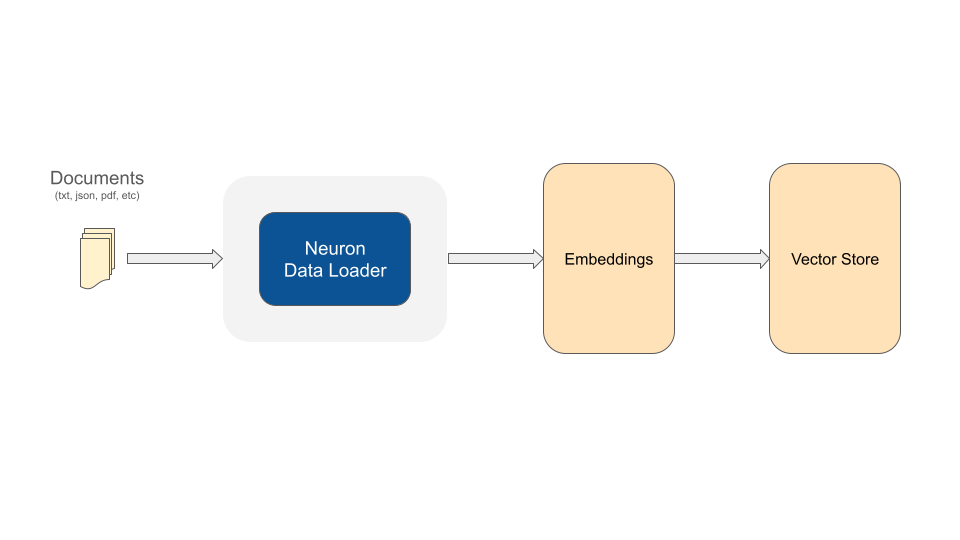
Neuron 为你提供了多种工具(数据加载器)来简化这一过程。
use App\Neuron\MyRAG;
use NeuronAI\RAG\DataLoader\FileDataLoader;

MyRAG::make()->addDocuments(
    // 使用文件数据加载器组件处理文本文件
    FileDataLoader::for(__DIR__.'/my-article.md')->getDocuments()
);
使用 Neuron 工具包,你可以创建数据加载流水线,并受益于统一接口,以便促进各组件之间的交互,例如嵌入提供方、向量存储和文件读取器。
FileDataLoader
如果你需要从文件中提取文本, FileDataLoader 它允许你处理任何简单的文本文档。
默认情况下 FileDataLoader 会按文件系统中的原样读取文件内容,但并非所有文件类型都适合按简单文本来处理。Neuron 为你提供了 ReaderInterface 以及若干预定义的读取器组件,覆盖最常见的文件格式。
请注意,每个文件读取器都关联着一个文件扩展名。因此,数据加载器会根据输入文件的扩展名自动使用相应的读取器。
PDF 读取器
HTML 转 Markdown 读取器
自定义读取器
你可以自由创建自定义文档读取器,只需实现下面这个小接口即可。一旦你的类实现了该契约,你就可以将它传给数据加载器,以自动转换你的文档。
StringDataLoader
如果你已经从数据库或其他来源获取到了文本,可以使用 StringDataLoader 将这些文本转换为文档,准备由链中的其他 Neuron 组件进行嵌入和存储:
文档元数据
从数据加载器获取文档数组后,你最终可以为文档附加自定义元数据,这些元数据会与文档的其他默认字段一起保存到向量存储中:
当这些自定义字段进入向量存储后,你就可以对支持该功能的数据库使用混合搜索。
文本分割器
Neuron 数据加载器接收输入的文件或文本,并生成一个由以下内容组成的数组: \NeuronAI\RAG\Document 对象。这些文档是可嵌入的单元。原始文本会被拆分成更小的文本片段,以便转换为嵌入并保存到向量存储中。
数据加载器用于将长文本拆分为块的逻辑可以通过不同策略进行自定义。Neuron 为此提供了一个专门的组件,称为“Splitter”,可以根据你偏好或需要的策略附加到数据加载器上:
DelimiterTextSplitter(默认)
这是所有数据加载器的默认分割器。
这些参数都会影响你的 RAG 代理的性能和准确性。
最大长度
每个块的长度都不会超过这个值,最终会被拆分成更小的文档。长度会影响嵌入表示的准确性。你的文本单元越长,嵌入表示就越不准确。
分隔符
文本首先会根据分隔符拆分成块。默认情况下,该组件使用句号字符。你最终可以使用适合文本的任意分隔符来自定义这个分隔符。
重叠
有时将前一个和后一个块中的词语带入文档会很有用,以增强文本相邻部分之间的语义关联。默认情况下不应用重叠。
SentenceTextSplitter
将文本拆分为句子,再按单词分组为块,并可选择按单词应用重叠。
最大单词数:每个块的最大单词数
重叠单词数:块之间重叠的单词数
实现自定义分割器
你可以通过实现以下 SplitterInterface:
你可以与外部服务交互,或创建自定义逻辑,将长文本拆分为更小的块。创建好自定义实现后,就可以将它用于数据加载器中:
将文档加载到 RAG 中
每个文档都携带要嵌入的文本、其来源,以及 RAG 模式所需的任何元数据。该模式会在定义 RAG 时进行配置。参见 在 RAG 中配置文档和模式.
在摄取前添加模式元数据
向量存储会根据模式验证每个文档。请在加载后、调用之前添加必需且可筛选的元数据 addDocuments().
使用模式中声明的类型。例如,整数字段需要 2026,而不是 '2026'.
模式中未声明的元数据也是允许的。它必须包含 JSON 安全的值:字符串、整数、浮点数、布尔值、null,或包含这些值的数组。
手动创建文档
创建一个 Document 在不需要加载器时直接创建文档。设置来源可以让后续替换或删除更可预测。
添加元数据后再拆分文档
手动创建文档时,可以在拆分前添加元数据。内置分割器会将来源和元数据复制到生成的每个块中。
对文档进行嵌入并存储
RAG::addDocuments() 完成摄取。它会验证每个文档,创建其嵌入,并将其存储到已配置的向量数据库中。
默认情况下,文档会按 50 个一批进行处理。当嵌入提供方有要求时,可更改批次大小:
模式验证会在嵌入请求之前进行。因此,缺少必需元数据或类型错误会在消耗嵌入 token 或为该批次写入部分数据之前失败。
常见验证错误
Neuron 会在数据库 I/O 之前拒绝无效文档。最常见的原因有:
必需字段缺失或为 null;
某个元数据值的类型与模式不一致;
元数据包含对象或其他非 JSON 安全值;
应用尝试将保留的文档属性用作元数据。
重新索引知识源
重新索引是 RAG 系统设计中的热门话题,因为将文本拆分成块的做法,会使在原始知识内容发生变化时更新单个信息片段变得困难。
在 Neuron 中,The Document 类旨在携带一些元数据,帮助你识别存储到向量数据库中的每一条知识来源,例如 sourceType 和 sourceName 字段。利用这些信息,你可以轻松地用更新后的文件内容版本来更新向量存储,而该文件之前曾被用作知识来源。
如果 sourceType 和 sourceName 文档中的这些项已经存在于向量存储中,它们将被删除,而新版本的文档将被保存。其他文档将照常存储到向量数据库中。
使用独立组件
在下面的示例中,我们使用 RAG 代理实例来处理摄取流水线的最后一步:为文档块生成嵌入,并将它们存储到向量数据库中。
除了利用 RAG 代理实例之外,你也可以将嵌入提供方和向量存储作为独立组件使用。请记住,这里的向量存储必须与 RAG 代理使用同一个连接。
通过这个简单流程,你可以将 GB 级数据摄取到向量存储中,为你的 RAG 代理提供输入。
最后更新于